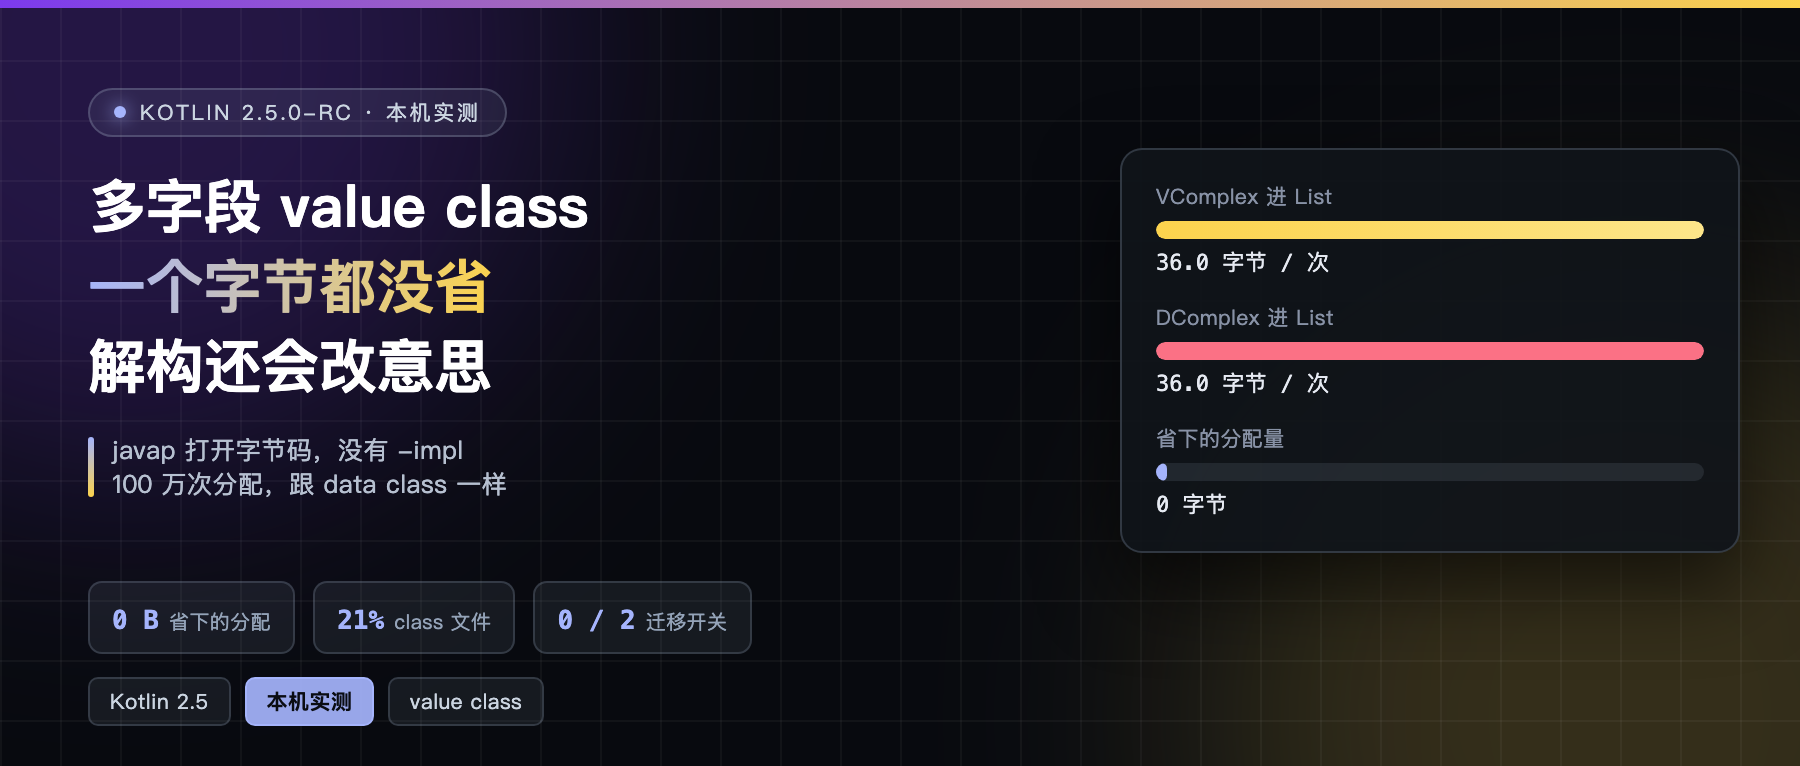
2026 年 11 月 11 日,Kotlin 2.5.0-RC 发布,官方重点推的是 full value classes。多字段的 value class,听起来就该是零成本抽象。
上个月 Beta2 出来的时候,我写过一轮变更清单,讲的是发布格式和几处默认值。这次我想量一件上次没量的事:它到底省不省内存。
装完编译器,第一件事不是照着文档写 demo,是拿 javap 去看它生成了什么。
结论先说:字节码里就是个普通类,一个 inline 痕迹都没有。
先确认编译器认什么
下载 kotlin-compiler-2.5.0-RC.zip,解压,版本是 kotlinc-jvm 2.5.0-RC,跑在 JRE 21.0.10 上。
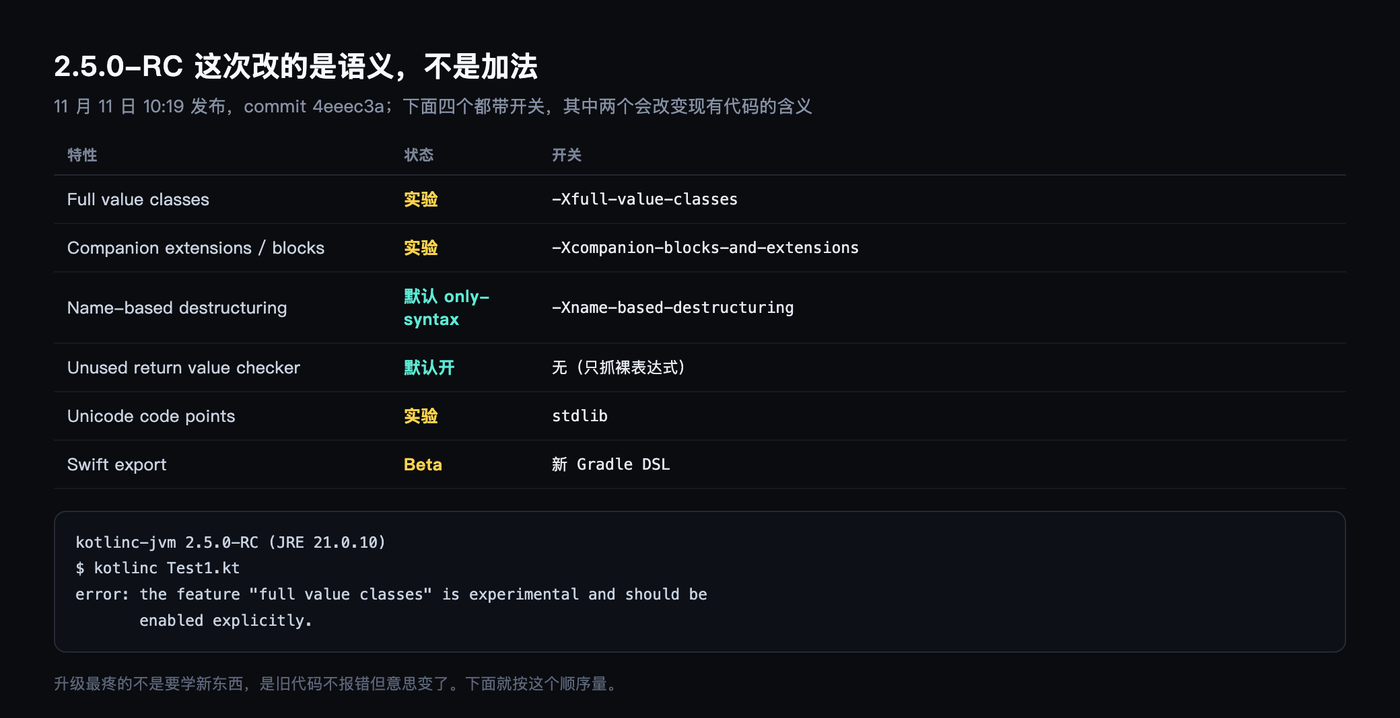
第一步就撞墙。写一个 value class VComplex(val real: Double, val imaginary: Double),编译直接报错:
the feature “full value classes” is experimental and should be enabled explicitly.
要加 -Xfull-value-classes 才认。官方文档写道,这功能是 Experimental,要显式开启。这句话没错,只是它没告诉你开启之后会看到什么。
字节码比文档诚实
写两组对照。一组 data class DComplex(real, imaginary),一组 value class VComplex(real, imaginary),字段一样、类型一样。
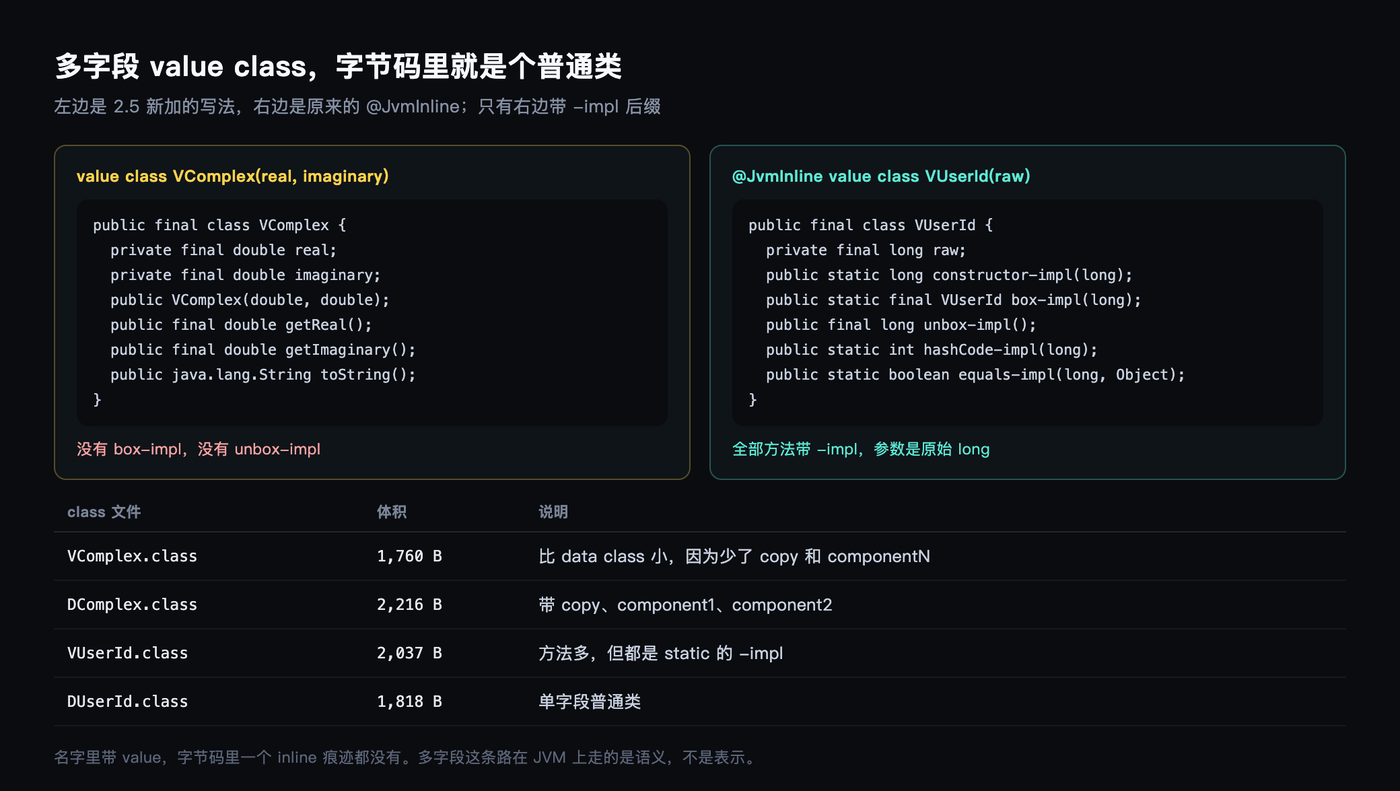
javap -p 看 VComplex:一个 private final double real,一个 private final double imaginary,一个两参构造器,两个 getter,一个 toString。
就这样。没有 box-impl,没有 unbox-impl,也没有把两个 double 压成别的表示。
再看单字段的 @JvmInline value class VUserId(val raw: Long),完全是另一副样子:constructor-impl(long)、box-impl(long)、unbox-impl()、hashCode-impl(long)、equals-impl(long, Object),每个方法的参数都是原始 long。
这才叫 inline。多字段那个不是。
那它到底省不省
我用 ThreadMXBean.getCurrentThreadAllocatedBytes 量分配,100 万次,看每次平均分配多少字节。
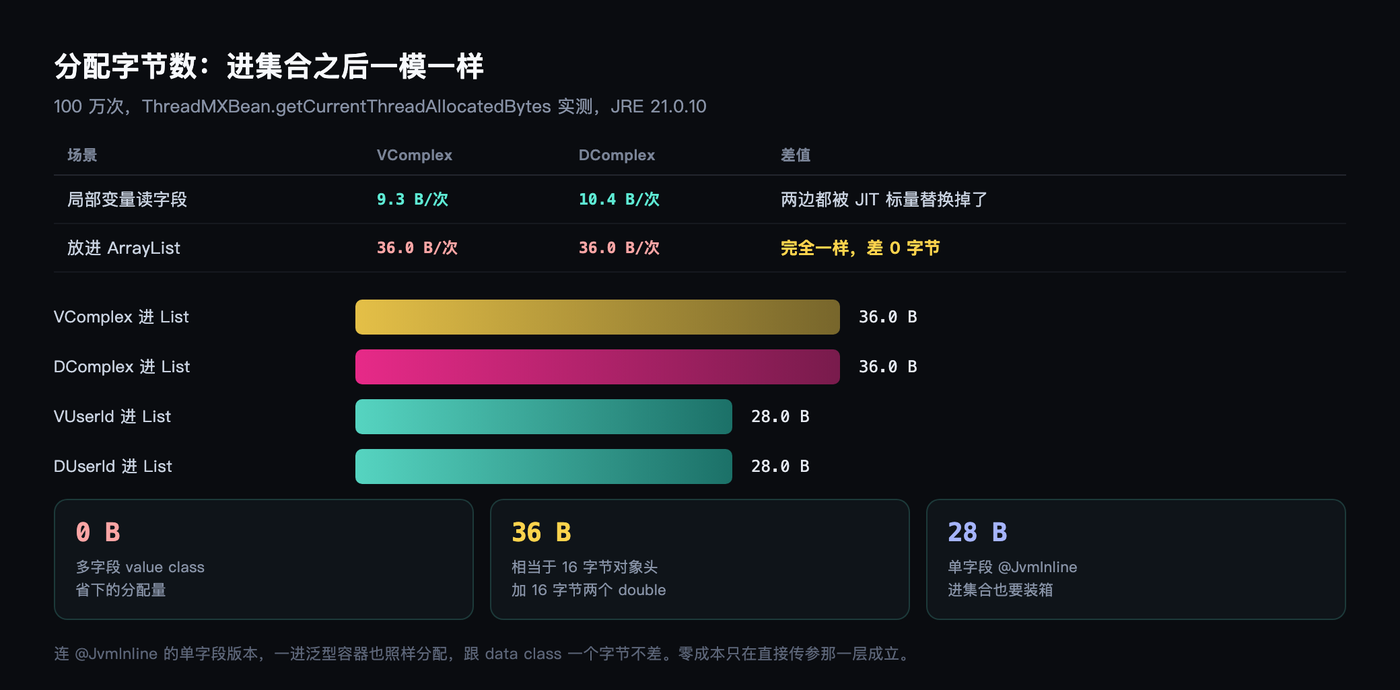
第一轮测局部变量读字段:VComplex 9.3 字节,DComplex 10.4 字节。两个数字都远小于一个对象该有的体积,因为 JIT 做了标量替换,对象根本没造出来。
这个测法不成立。改成放进 ArrayList,让对象必须存在。
VComplex 进 List:36.0 字节每次。DComplex 进 List:36.0 字节每次。
一模一样,差 0 个字节。
36 这个数也好解释:16 字节对象头加 16 字节两个 double,整数。
所以多字段 value class 在 JVM 上,一个字节都没省下来。它跟 data class 唯一的体积差别在 class 文件,VComplex.class 1760 字节,DComplex.class 2216 字节,小了 21%,少的是 copy 和 componentN 那几个方法。
连 @JvmInline 也躲不过
顺手量了单字段的对照。VUserId 进 List 28.0 字节,DUserId 也是 28.0 字节。
同样一个字节不差。
原因很直白:一旦进泛型容器就必须装箱,装箱之后它就是个对象,跟普通类没区别。
所以「inline value class 是零成本抽象」这句话,成立范围只在直接传参那一层。你把它塞进 List、Map、Array<Any>,成本立刻回来。
这不是 2.5 的问题,是 JVM 泛型擦除的老规矩。只是很多人把 value class 当成省内存手段在用。
它省的其实是语义
那多字段 value class 图什么。
图的是「两个内容相同的实例不该有身份差别」。data class 的 == 比内容,但两个实例仍是两个对象,有各自的引用、各自的锁、各自在堆上的位置。
value class 把这个身份拿掉了。你不能依赖引用相等,也就不能拿它当锁,不能靠对象身份做缓存 key。
代价是少了 copy(),也少了 componentN()。文档提到以后会有 copy vars,现在还没有。
我实测了去重和 equals:setOf(a, b).size 都是 1,toString 输出 VComplex(real=1.0, imaginary=2.0),跟 data class 一样。
所以它给的是约束,不是性能。
它跟 data class 到底差在哪
我把 equals 的边角也量了一遍,因为这里最容易藏意外。
NaN 比 NaN:VComplex 是 true,DComplex 也是 true。负零和正零:两边都是 false。跟 data class 一个行为,都走 Double.compare 的语义,没有额外惊喜,也没有额外坑。
继承这块倒是有点新东西。value class 可以实现 sealed interface,value object 也能进去:
sealed interface Resp value class Found(val id: Int) : Resp value object Unknown : Resp
Unknown::class.java.name 打出来就是 Unknown,Found(1) is Resp 编译器直接判定为 true,还给了句警告说「这个检查永远是 true」。因为 value class 的继承关系在编译期就定死了,运行时没有第二种可能。
所以它跟 data class 的实质差别只有三条:没有 copy(),没有 componentN(),没有对象身份。
前两条是减法,第三条是它存在的理由。
解构这边还有个静默陷阱
RC 把名称式解构的 only-syntax 模式设成了默认。这部分的坑我上次写过,这次补一个更硬的证据。
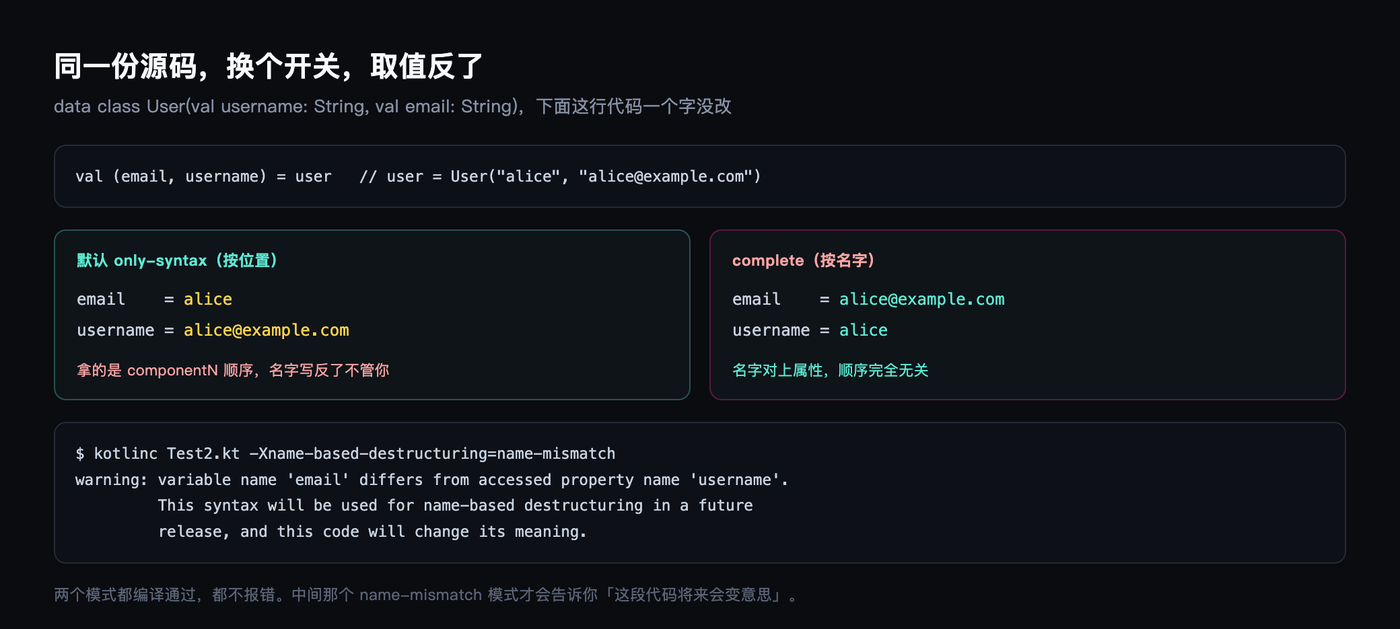
data class User(val username: String, val email: String),实例 User("alice", "alice@example.com"),然后一行 val (email, username) = user。
变量名和属性名写反了。这在生产代码里太常见,敲的时候只看顺序不看名字。
默认模式跑出来:email 是 alice,username 是 alice@example.com。完全错位。
加上 -Xname-based-destructuring=complete 再编译同一份源码,一个字没改,跑出来:email 变成 alice@example.com,username 变成 alice。
两个模式都编译通过,都不报错,运行结果完全相反。
中间还有个 name-mismatch 模式,它不改行为只警告,说的原话是 variable name ’email’ differs from accessed property name ‘username’,this code will change its meaning。
它没说这是 bug,说的是「将来这段代码的意思会变」。想提前排雷,只有这个模式能用。
迁移开关,RC 里还是没有
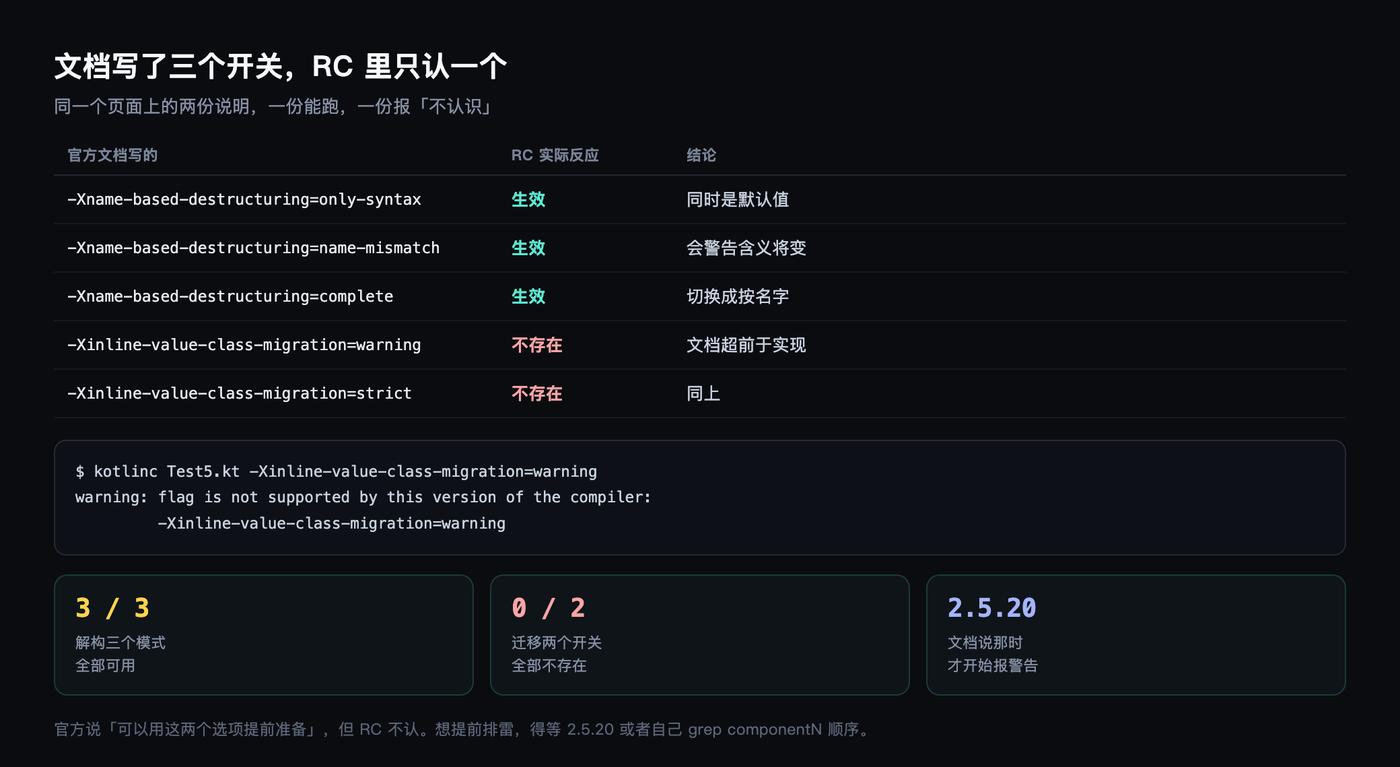
官方文档在讲迁移时指出:从 2.5.20 开始对未标记的单字段 value class 报警告,2.6 或 2.7 升成错误,在那之前可以用 -Xinline-value-class-migration=warning 和 strict 提前准备。
我照着试了,编译器回:flag is not supported by this version of the compiler。两个都不认。
三个解构模式全部可用,两个迁移开关一个都没有。文档不是错的,它描述的是即将到来的状态,但写在 RC 页面里,读起来像现在就能用。
两分钟自己验一遍
不用信我,命令都在下面。
下载编译器解压,写一个最小的对照文件,加开关编译,然后用 javap 打开两个 class 对比。看有没有 -impl 后缀,一眼就知道是不是 inline。
分配量的测法也简单,ThreadMXBean 两行就够:
val mx = ManagementFactory.getThreadMXBean() as com.sun.management.ThreadMXBean
val before = mx.getCurrentThreadAllocatedBytes()
// 这里跑你的循环
val after = mx.getCurrentThreadAllocatedBytes()
println((after - before) / 循环次数)
有一点必须注意:局部变量那个场景量不出东西,JIT 会把对象整个消掉,跑出来两个数都只有十来个字节。要放进集合再量,那才是对象真造出来的样子。
我第一次就栽在这儿,差点写下一个「两边都省」的错结论。
升级前你可以做的
三件。
第一,把 -Xname-based-destructuring=name-mismatch 挂到构建里跑一遍。零行为变化,纯检查,跑出来的警告就是将来会变意思的行号。
第二,如果你在用多字段 value class,先想清楚是冲着省内存去的还是冲着语义去的。冲着省内存去的话,实测告诉你省不下。
第三,别把 value class 当性能优化项。真正的零成本只在单字段直接传参时成立,而且必须显式写 @JvmInline,因为从 2.5 起 value class 这个词已经不再自动等于 inline 了。
至于 full value classes 本身,实验阶段,开关一关就没有,要在生产里用还得等。
我这次量下来最想说的一句:一个名字里带 value 的类型,在 JVM 上依然是个对象。想省内存,还是得看你的数据结构放在哪儿。