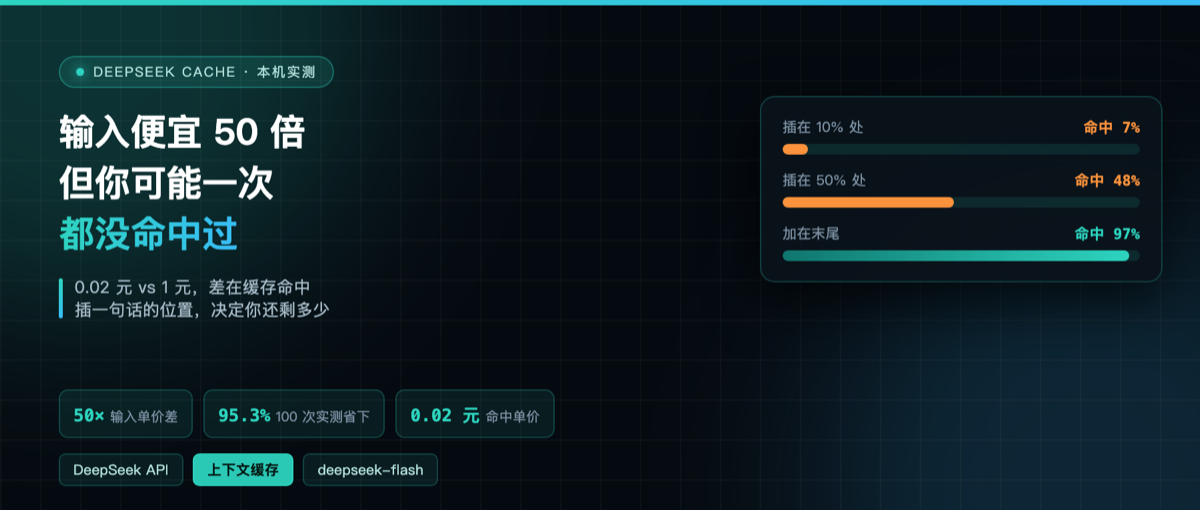
DeepSeek 现在的价目表上,deepseek-flash 的输入分两栏:缓存命中 0.02 元每百万 tokens,未命中 1 元。整整五十倍。
这个数字大家都在转发,但很少有人问一句:我到底命中了没有。
我把这件事从头量了一遍。答案比想象中更难拿到,因为命中不命中,决定权不完全在你手里,它更多取决于你那句话是放在开头还是放在结尾,而这件事在文档里只是一句轻描淡写的描述。
先看价目表是怎么写的
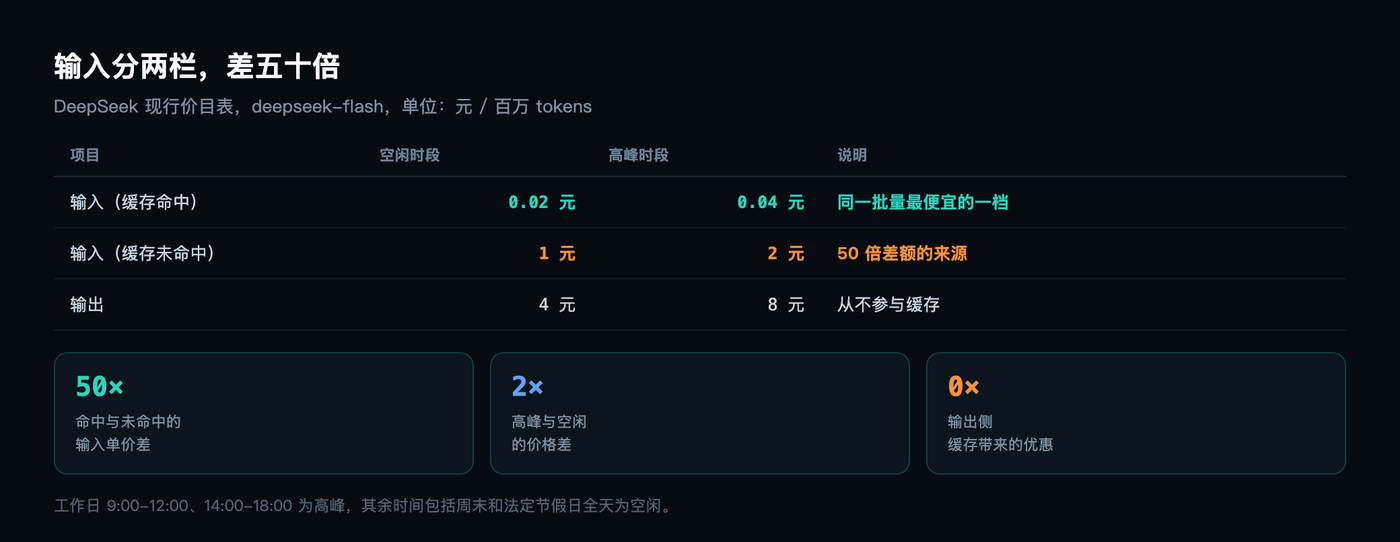
官方定价页现在把两个模型并排放,deepseek-flash 和 deepseek-v4-pro 的输入分两栏,缓存命中和未命中,这里的原文是这样:
| 缓存命中 | 未命中 | |
|---|---|---|
| deepseek-flash 空闲 | 0.02 元 | 1 元 |
| deepseek-flash 高峰 | 0.04 元 | 2 元 |
输出是 4 元每百万(空闲),13.5 元那档属于 deepseek-v4-pro。两者不是同一个模型,flash 的输入输出比是 1 比 4,pro 是 1 比 3。
注意空闲时段就是高峰的一半。工作日 9 点到 12 点、14 点到 18 点算高峰,其余时间包括周末和法定节假日全天都是空闲。也就是说,晚上和周末跑批,价格直接砍半。这条比缓存更容易吃满,而且不需要改任何代码。
一次请求里就能看到命中明细
/chat/completions 的返回里,usage 字段比很多人以为的要详细:
{"prompt_tokens": 15520, "completion_tokens": 30,
 "prompt_cache_hit_tokens": 15360, "prompt_cache_miss_tokens": 160}
三次请求,同一个长前缀,只换末尾的提问。第一次是冷启动,hit 为 0,15,520 全部按 1 元计费。第二次开始 hit 变成 15,360,只有 160 个 token 算未命中。
也就是说命中率 99%,输入成本从每百万 1 元掉到 0.02 元左右。那 160 个未命中的 token 是每次末尾的提问本身,属于必然开销。
这个字段很多 SDK 不透传,得自己从原始响应里读。如果你用的是封装过的客户端,先确认它有没有把 prompt_cache_hit_tokens 保留下来,没有的话你连自己有没有命中都不知道,后面所有的优化讨论都无从谈起。
但命中的判定比想象的严格
这是这次动手最意外的部分。我做了一组对照实验,前缀七千多 token,先建立一次缓存,然后在不同位置插入一句新内容,看命中还剩多少。
| 插入位置 | 命中 token | 未命中 | 命中率 |
|---|---|---|---|
| 10% 处 | 512 | 7273 | 7% |
| 25% 处 | 1664 | 6121 | 21% |
| 50% 处 | 3712 | 4073 | 48% |
| 75% 处 | 5632 | 2153 | 72% |
| 90% 处 | 6784 | 1001 | 87% |
| 末尾追加 | 7552 | 233 | 97% |
命中率几乎精确等于插入位置之前的 token 占比。
这意味着缓存是按前缀逐段匹配的,你在中间无论插入什么,后面全部作废。插在 10% 的位置,你只保住 7%;插在末尾,保住 97%。
很多人以为「改一点内容只会影响那一点」,实际情况是那条线之后的一切都要重算。
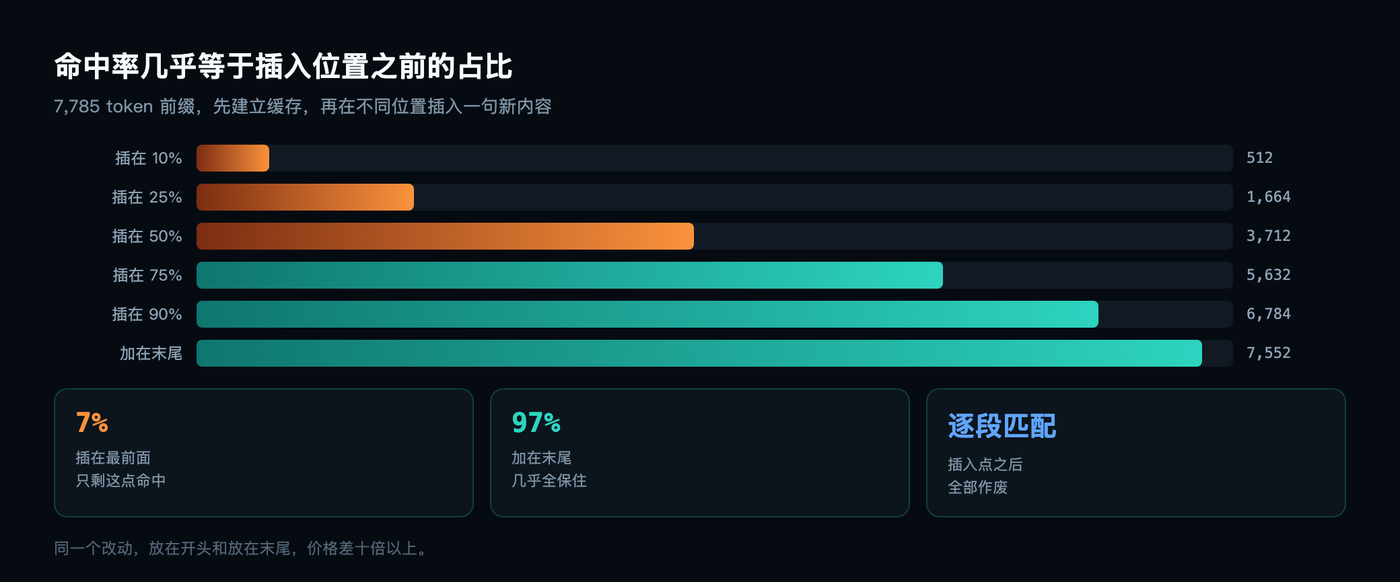
反过来,把同样的这句话加到对话末尾,命中率能保住九成以上,成本和前一次几乎一样。同一个改动,两个位置,价格差十倍以上,这件事在文档里没有明写,只能自己量。
这个规则决定了怎么组织 prompt
既然前缀匹配是逐段的,那么变的东西就该往后放,不变的东西往前放。这条和写 prompt 的直觉正好相反。
反例是最常见的那种写法:把用户当前的问题放在 system 里,把项目规范、代码库上下文放在后面跟着走。这样每换一个问题,前缀第一句就变了,命中率归零。
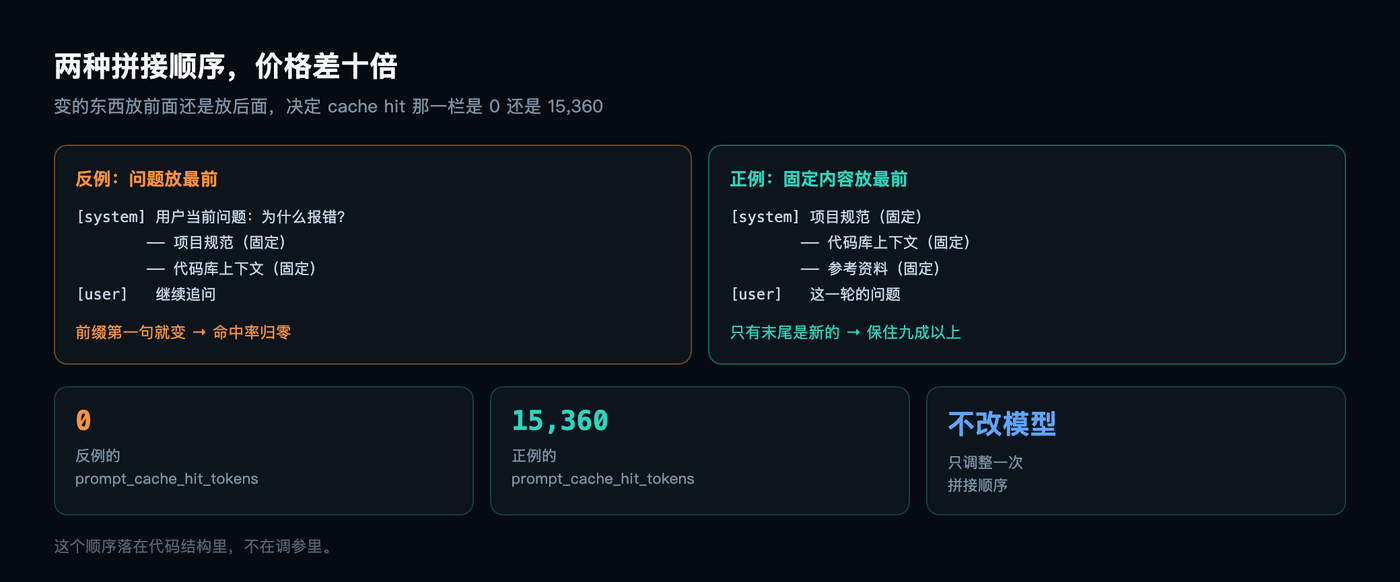
正例正好相反,固定内容放最前面,提问放末尾。
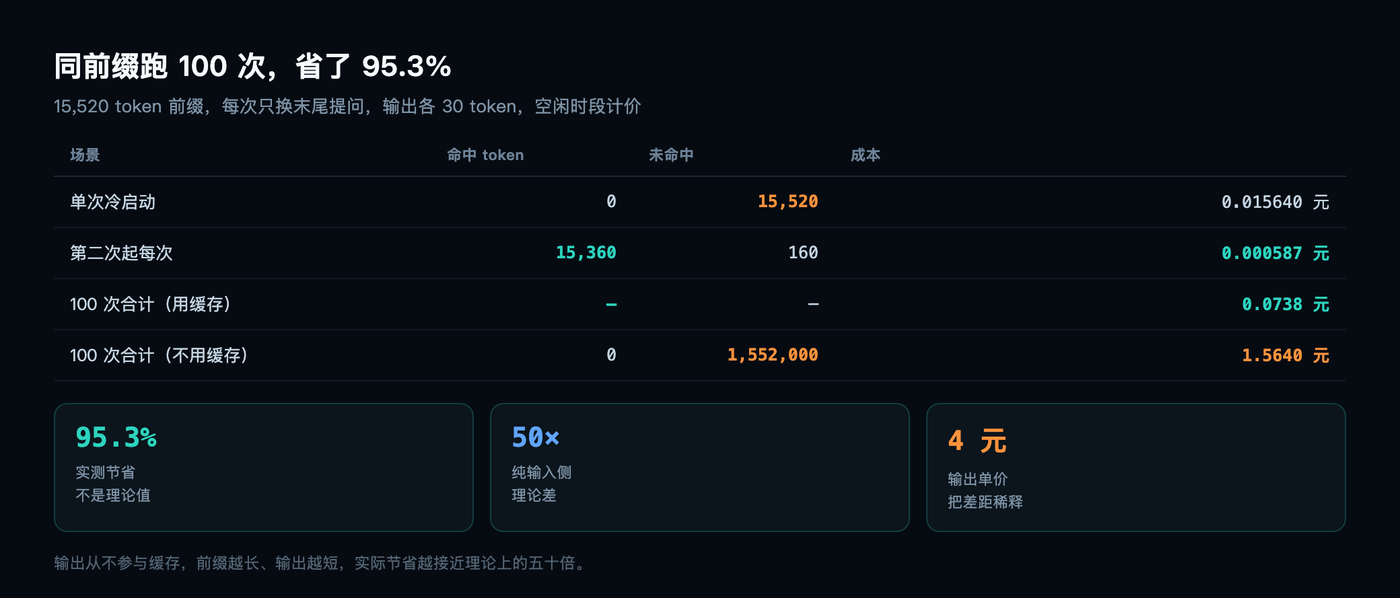
我做了一个更贴近真实的对照。同一个 15,520 token 的前缀,连续跑 100 次,每次只换末尾问题,前缀一个字都不动。这个场景就是最常见的日常用法,一轮对话里只有末尾那一句是新的,前面全是既有的历史。
用上缓存,100 次总计 0.0738 元。不用缓存,1.5640 元,省了 95.3%。这个数字和我预期的五十倍差很远,原因就在下面这句。
注意这个 95.3% 不是五十倍,因为输出部分不参与缓存,30 个 token 的输出每次都要花 4 元每百万。前缀越长、输出越短,缓存带来的收益越接近理论上的五十倍。
这份缓存能活多久
我测了同一个前缀在 28 秒、90 秒、150 秒后重复请求,命中率都稳定在 96%,没有衰减。
官方文档对保留时间的描述是按小时计的,具体时长取决于两件事:是不是最近被用过,以及同一时刻缓存空间的压力。频繁用的前缀基本不用担心,跑一次就晾着的要留意。
我的测法比较保守,只验证了短期。真要长期跑,让同一套前缀在一天之内被反复用到,闲置本身就会让缓存失去意义。
顺带说一个容易被忽略的点。缓存是按前缀最短有效长度生效的,太短的前缀本来就不值得建缓存,那点 token 省下来的钱还不够你多写几行代码的功夫。前缀至少要几千 token 才开始有感知,大到一万以上,命中和不命中就是两个价格区间。
三条能直接抄的结论
命中率按前缀逐段算,插一句话的位置决定你还剩多少。要改内容,改末尾。
高峰期价格是空闲期两倍,工作日白天算高峰。能挪到晚上和周末跑的批量任务,直接省一半,不需要任何技术改动,也不用改一行代码,只是换个时间点跑而已。
输出从来不参与缓存,这是计算收益时最容易算错的一项。如果你的任务是大前缀配长输出,缓存的五十倍会被输出成本稀释,实际省下的比例要自己按比例算一遍。
我的判断
缓存命中这件事,DeepSeek 的价格页写得很清楚,但没人告诉你怎么才能拿到。
真正的门槛不在 API 调用方式上,而在你怎么组织那段文本。前缀稳定是设计出来的,不是调出来的,它落在代码结构里,不在调参里。
随手拼接的 prompt,cache hit 那一栏永远是 0。
所以第一件事不是优化,是先看一眼返回里的 prompt_cache_hit_tokens。如果那个数是 0,你现在付的就是全额,五十倍折扣一分没拿到,还以为自己已经在省钱了。